 Mariana Costa
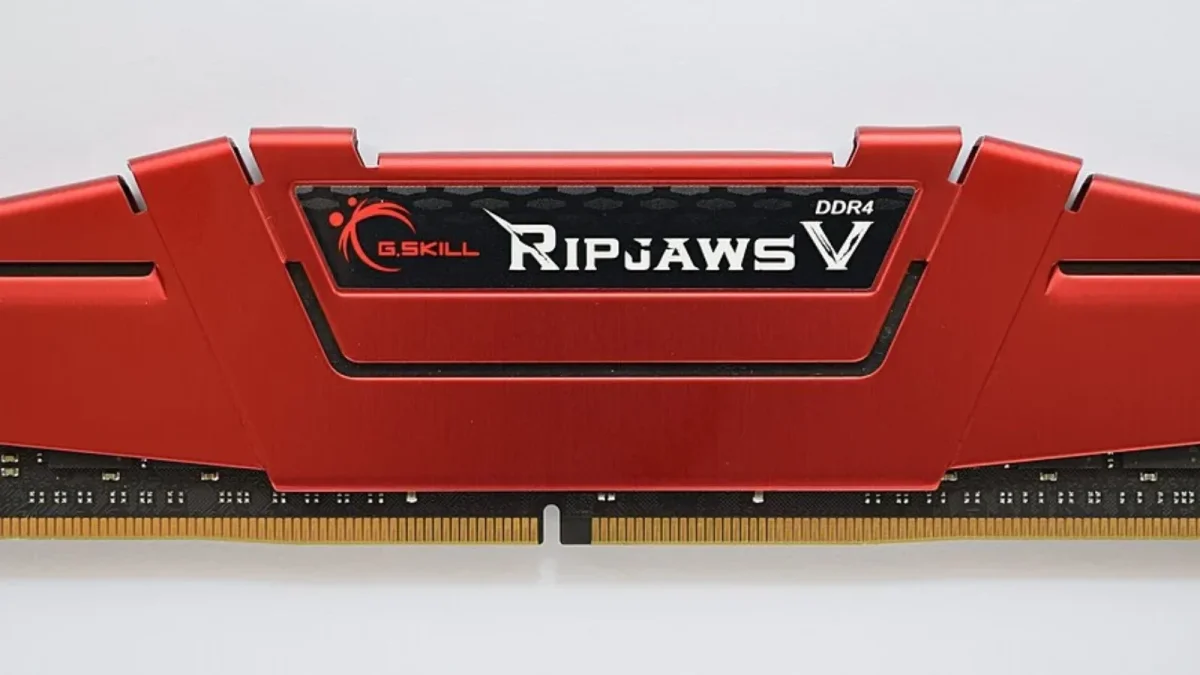
IA local no PC — montar uma máquina para rodar modelos de linguagem não é só somar gigabytes: a escolha entre RAM e VRAM define se o modelo simplesmente cabe no sistema ou se roda com velocidade prática. Para quem quer respostas rápidas e contexto longo, a configuração mínima e o método de quantização podem transformar a experiência.
Recomendações práticas por faixa de memória
Para começar sem GPU dedicada, 16 GB de RAM permitem rodar modelos pequenos e experimentar variantes de 7B a 8B quantizadas, ainda que a execução fique mais lenta quando feita só na CPU. Com 32 GB de RAM e 12–16 GB de VRAM, o PC passa a suportar melhor modelos entre 8B e 14B e a alternar entre cargas sem esgotar a memória.
 Global Election Simulator: ferramenta que não é pesquisa eleitoral
Leia a matéria completa →
 Mega-Sena: concurso 3065 sem vencedor; 47 apostas fizeram a quina
Confira o resultado e o prêmio →
 Exército do Lula fica fora do ar por 48h durante votação
Leia a matéria completa →
 Tabela do Brasileirão 2026: classificação atualizadaVer classificação, artilharia e próximos jogos →
Quem busca trabalhar com modelos maiores (20B–32B) deve considerar GPUs com 24 GB de VRAM e 64 GB de RAM para margem de contexto; workstations para 70B costumam exigir 48–64 GB de VRAM ou mais e memórias de sistema próximas a 96–128 GB.
Para rodar IA local no PC, 16 GB de RAM permitem começar com modelos pequenos, mesmo sem uma placa de vídeo dedicada.
Quantização, contexto e como testar seu PC
A quantização reduz o tamanho dos pesos (ex.: Q4, Q8, FP16) e amplia o que cabe em cada GPU: formatos 4-bit costumam economizar muito espaço, mas podem afetar a qualidade em tarefas sensíveis. Além disso, o consumo total inclui o KV cache da conversa; aumentar a janela de contexto (tokens) eleva a memória necessária e pode estourar GPUs aparentemente compatíveis.
Antes de comprar, teste localmente: ferramentas como Ollama e LM Studio exibem estimativas de recursos; comandos de linha como ollama run qwen3:4b e ollama ps ajudam a verificar se o modelo usa CPU ou GPU. Em Macs com Apple Silicon, a memória unificada altera a dinâmica, tornando 16–32 GB um ponto de entrada razoável dependendo do modelo.
O que você acha? Você já testou IA local no seu PC ou pretende montar uma máquina para isso? Para acompanhar mais conteúdo sobre hardware e IA, acesse nossa editoria de Tecnologia.
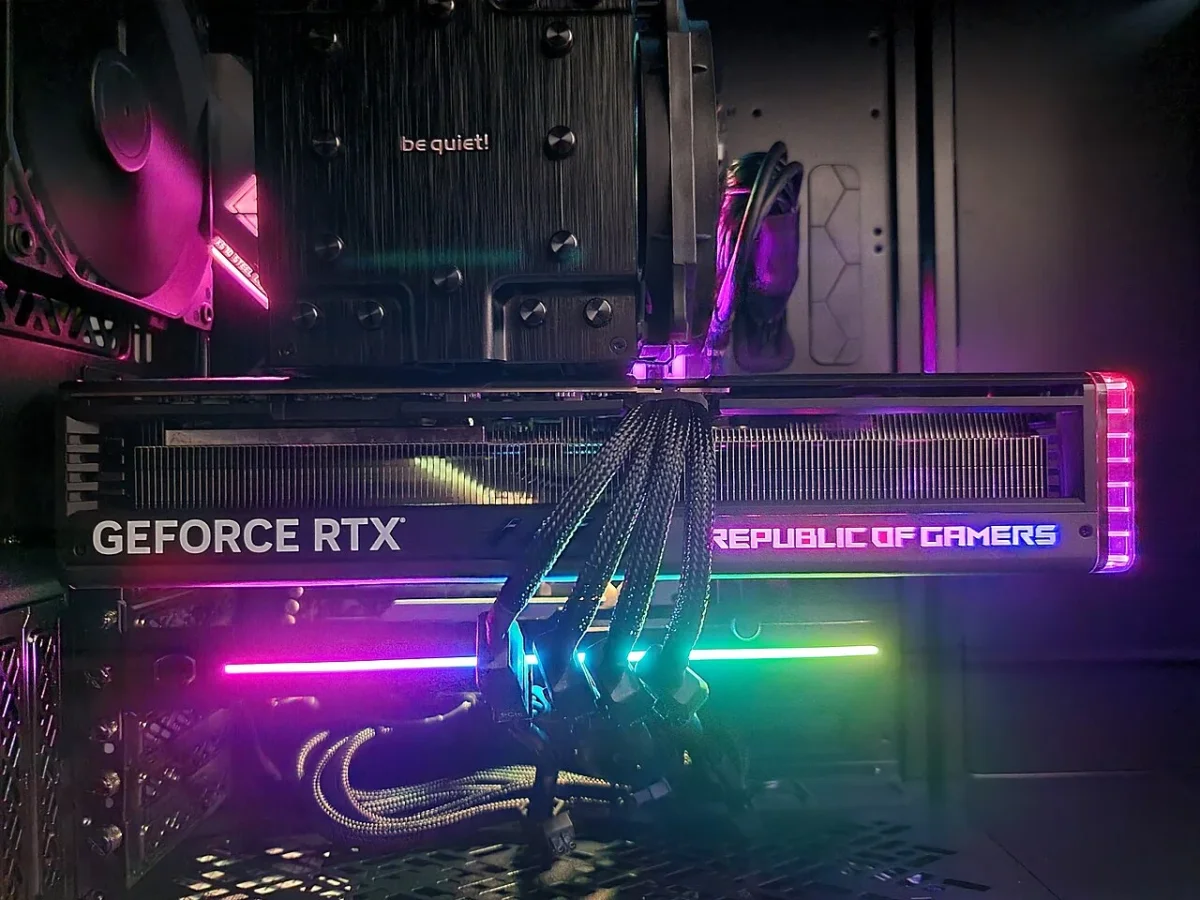 Foto: Divulgação
Perguntas Frequentes
Qual configuração a IA local recomenda para começar no PC sem placa de vídeo?
A recomendação para IA local no PC sem GPU é ter pelo menos 16 GB de RAM, que permitem executar modelos pequenos e experimentar variantes de 7B a 8B em quantizações compactas. A velocidade dependerá do processador; testes iniciais com janelas de contexto de 4.096 ou 8.192 tokens ajudam a evitar estouros de memória.
É possível rodar IA local com apenas a CPU e como fica a performance?
Rodar IA local somente na CPU é viável: modelos pequenos (1B–4B) costumam responder de forma aceitável em máquinas com 8–16 GB de RAM, mas a latência sobe muito para modelos maiores. Ferramentas como llama.cpp e runtimes de CPU permitem testar sem GPU, porém respostas longas ou multitarefa ficam notavelmente mais lentas.
Que VRAM é necessária para um modelo de 14B e como planejar a compra da GPU?
Para um modelo de 14B, a VRAM recomendada costuma ser da ordem de 16 GB para rodar a variante inteira; com quantizações e contexto reduzido, 12 GB podem funcionar em algumas situações. Planeje deixando margem para cache e buffers: comparar o tamanho do pacote baixado com a estimativa do runtime é essencial antes da compra.