 Beatriz Farias
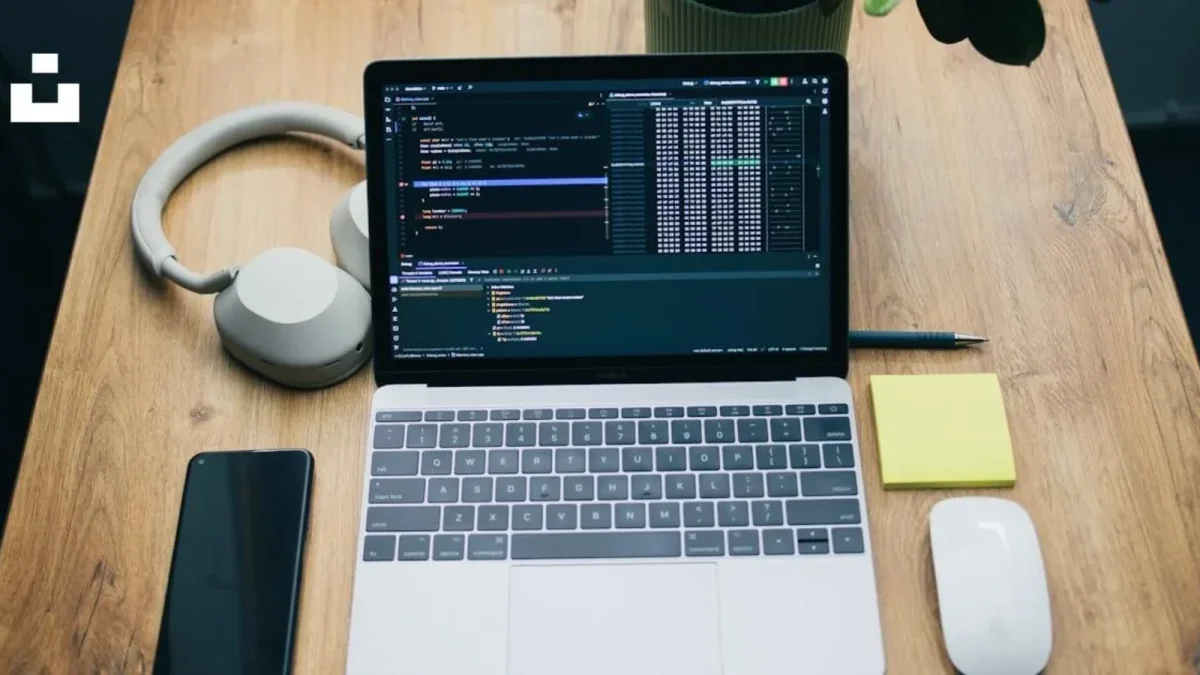
IA local — A barreira técnica para experimentar assistentes de texto em um notebook modesto reduziu: com 8 GB de RAM é possível rodar modelos compactos, mas a diferença prática se revela em velocidade e estabilidade. Este guia foca no que funciona, quanto ocupa em disco e quais ajustes reduzem travamentos, sem depender de GPU dedicada.
Modelos que cabem em 8 GB e o que esperar
Modelos de 600 milhões a 3 bilhões de parâmetros são os mais indicados para começar. Exemplos práticos incluem Qwen3 0.6B (≈523 MB), Gemma 3 1B (≈806 MB), Qwen3 1.7B (≈1,4 GB) e variantes compactas do Qwen3.5.
 Galaxy A57: preço cai para R$ 1.769 e reforça o apelo de compra
Leia a matéria completa →
 Flávio Bolsonaro espalha fake news sobre Lula
Leia a matéria completa →
 Flávio Bolsonaro: suposta trama de Daniel Vorcaro ameaça 2º turno
Leia a matéria completa →
 Tabela do Brasileirão 2026: classificação atualizadaVer classificação, artilharia e próximos jogos →
Esses arquivos representam o tamanho do download; a execução exige memória adicional para o programa, cache de contexto e o próprio sistema operacional. Em CPUs mais antigas as respostas podem demorar, mas tarefas como resumir textos, reescrever parágrafos ou gerar pequenos códigos costumam ser viáveis.
Modelos como Qwen3 0.6B, Gemma 3 1B e Qwen3 1.7B ocupam entre 523 MB e 1,4 GB de download e são opções práticas para começar em máquinas com 8 GB de RAM.
Como instalar e otimizar: passos práticos com Ollama
Uma rota direta é instalar uma ferramenta que faça o gerenciamento dos modelos e escolha versões quantizadas. No Windows, o fluxo sugerido inclui baixar o instalador do gerenciador, abrir o Terminal/PowerShell e executar comandos para baixar e iniciar o modelo, por exemplo: ollama run qwen3:1.7b.
Para reduzir consumo, prefira variantes quantizadas (formato Q4_K_M), diminua o contexto de sessão (ex.: /set parameter num_ctx 2048), feche programas desnecessários e descarregue o modelo após o uso (ollama stop qwen3:1.7b e ollama rm qwen3:1.7b para remover).
O que você acha? Já tentou rodar uma IA local em um notebook com 8 GB de RAM? Para acompanhar mais guias e análises de hardware e software, acesse nossa editoria de Tecnologia.
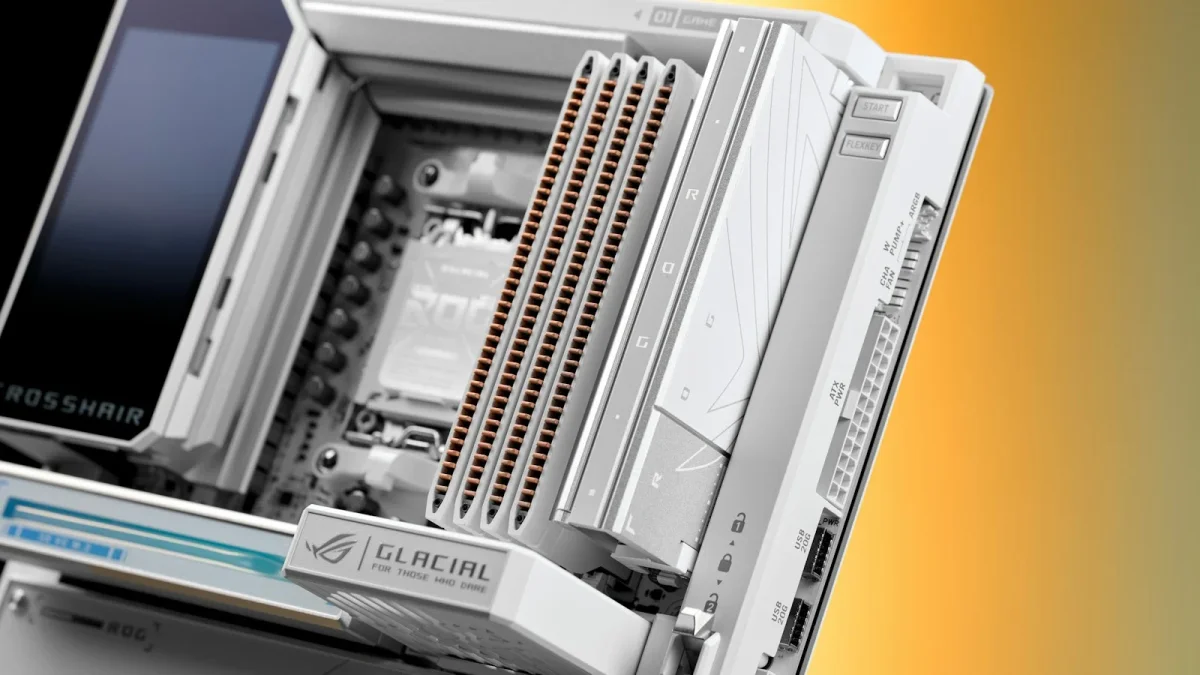 Foto: Divulgação
Perguntas Frequentes
Quais modelos de IA local funcionam bem num PC com 8 GB de RAM?
IA local em PCs com 8 GB de RAM costuma rodar bem com modelos compactos: Qwen3 0.6B (≈523 MB), Gemma 3 1B (≈806 MB) e Qwen3 1.7B (≈1,4 GB). Essas variantes exigem menos RAM e, quando quantizadas, reduzem o uso de memória, tornando tarefas como resumos, reescritas e pequenos códigos viáveis.
É possível rodar IA local sem placa de vídeo dedicada?
IA local sem GPU é viável: modelos podem executar na CPU usando RAM como recurso principal. Em muitos sistemas sem GPU dedicada a carga fica em 100% CPU e as respostas são mais lentas; placas com VRAM aceleram a geração, mas não são obrigatórias para variantes menores e quantizadas.
Como instalar o Qwen3 1.7B localmente usando Ollama em Windows?
Ollama permite baixar e rodar o Qwen3 1.7B com o comando ollama run qwen3:1.7b; o arquivo ocupa cerca de 1,4 GB de download. Após iniciar, ajuste o contexto (/set parameter num_ctx 2048) se a memória faltar, monitore uso no Gerenciador de Tarefas e descarregue o modelo com ollama stop qwen3:1.7b.